 Por
RAG: Como a IA busca contexto antes de gerar a resposta?
Jean Pierre Lessa e Santos Ferreira, especialista em tecnologia, software e inteligência artificial, descreve a geração aumentada por recuperação, ou RAG, como o mecanismo que separa um sistema de IA genérico de um sistema que conhece a empresa por dentro. A técnica já sustenta boa parte dos assistentes corporativos que respondem com precisão sobre processos internos, sem que o modelo tenha sido treinado especificamente para isso.
O nome técnico intimida, mas o mecanismo por trás dele é direto: buscar antes de responder. Entender esse funcionamento separa quem constrói um sistema confiável de quem apenas conecta um modelo pronto a uma pilha de documentos e espera que funcione sozinho.
O problema que RAG resolve: um modelo que não sabe o que aconteceu depois do treinamento
Um modelo de linguagem é treinado até uma data específica, e tudo o que acontece depois, como uma nova política interna da empresa ou um produto lançado na semana passada, simplesmente não existe no conhecimento dele. Retreinar o modelo inteiro toda vez que algo muda é caro e lento demais para ser viável na maioria dos casos.
Jean Pierre Lessa e Santos Ferreira destaca que RAG resolve esse problema sem exigir retreinamento: em vez de depender só do que o modelo memorizou, o sistema busca a informação atualizada em uma fonte externa no momento da pergunta, e entrega esse contexto ao modelo junto com a pergunta original.
Como funciona a busca antes da geração da resposta?
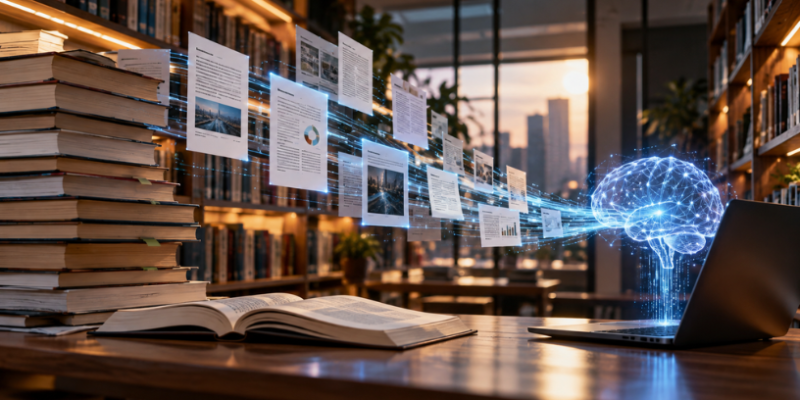
O processo tem duas etapas distintas. Primeiro, o sistema converte a pergunta do usuário em uma representação numérica e busca, em uma base de documentos, os trechos mais relacionados semanticamente a essa pergunta. Só depois esses trechos são enviados ao modelo, junto com a pergunta, para que ele formule uma resposta baseada nesse material.
Jean Pierre Lessa e Santos Ferreira observa que essa separação entre busca e geração é o que dá ao sistema a capacidade de responder sobre algo que aconteceu ontem, mesmo que o modelo em si tenha sido treinado meses atrás: a atualidade vem da base consultada, não do modelo.
Jean Pierre Lessa e Santos Ferreira
De onde vem a base que o modelo consulta?
Essa base normalmente reúne documentos internos, manuais, políticas e qualquer conteúdo relevante da empresa, organizado de forma que o sistema consiga buscar por similaridade de significado, não apenas por palavra exata. A qualidade dessa organização determina diretamente a qualidade da resposta final.
Jean Pierre Lessa e Santos Ferreira avalia que a maior parte dos problemas em sistemas baseados em RAG não vem do modelo de linguagem em si, vem da base de documentos mal estruturada ou desatualizada, que faz a etapa de busca trazer o trecho errado antes mesmo de o modelo entrar em ação.
O que pode dar errado quando a busca traz o trecho errado?
Se a etapa de busca recupera um documento desatualizado ou pouco relacionado à pergunta, o modelo ainda assim vai gerar uma resposta fluente e convincente, só que baseada em informação incorreta. Diferente de um erro óbvio de sistema, essa falha é silenciosa, porque a resposta continua parecendo correta na forma.
Jean Pierre Lessa e Santos Ferreira aponta que esse é o ponto mais sensível de qualquer sistema baseado em RAG: revisar constantemente o que está sendo recuperado, não apenas o que está sendo gerado, é o que evita que o sistema espalhe informação errada com aparência de certeza.
Por que RAG não é atualização de conhecimento, é consulta em tempo real?
O modelo continua sendo o mesmo depois de qualquer conversa usando RAG. Nada do que foi consultado fica retido nele para a próxima pergunta de outro usuário; cada busca acontece do zero, a cada nova interação, consultando a base no momento exato em que a pergunta chega.
Jean Pierre Lessa e Santos Ferreira explica que compreender essa diferença muda a forma como equipes técnicas mantêm esse tipo de sistema: o esforço contínuo não deveria estar em retreinar o modelo, e sim em manter a base de conhecimento consultada sempre atualizada, porque é dali que vem toda a precisão que a resposta final consegue ter.